扩散模型(Diffusion Models, DMs)沿着 LLM 确立的「预训练—微调」范式,在高保真、可控生成上稳步取得突出表现。但传统 DMs 在复杂推理、对生成路径的自主探索、以及对人类对齐复杂目标的适配上仍有明显短板。受 RLHF 在 LLM 上成功的启发,强化学习(RL)正作为关键的后训练机制,通过奖励驱动的轨迹优化,迭代地精炼扩散模型。本文是首个系统综述:RL 如何把扩散过程重塑为「以经验为中心、目标导向」的生成,横跨扩散语言、多模态、机器人与科学模型四类场景,并给出技术全景与实证对比。
这篇由 24 位作者(马致远、Zhiyuan Ma 等,含 Bowen Zhou、Kun He、Xiang Bai、Ning Ding 等)完成的工作已被 IEEE TPAMI 接收(arXiv:2610.21539,26 页、12 图、8 表),并配套一个持续跟踪该领域最新进展的公开仓库。
背景:从扩散到强化学习
标准扩散模型从离散到连续,把生成建模为逐步去噪的马尔可夫过程。一旦进入训练,它本质上是监督信号下的去噪目标优化——模型只学会「还原」,却缺乏「主动探索生成路径」和「朝某个目标优化」的能力。RL 的介入正是补足这一环:用奖励信号对整条扩散轨迹做优化,让模型不再只是被动复原,而是朝可度量的目标收敛。
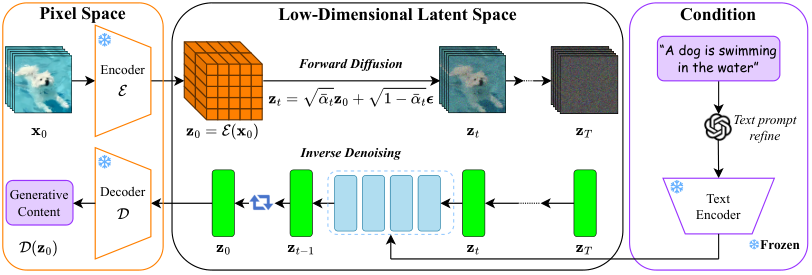
图 1 潜扩散模型(LDM)结构:RL 作用于去噪轨迹的每一步。
论文用一个技术全景图把 RL 在扩散里的多重角色一次讲清:RL 不只是给最终样本打分,而是可以介入轨迹级——每一步去噪都是一个状态-动作-奖励三元组,优化对象是整条采样路径而非单个终态。
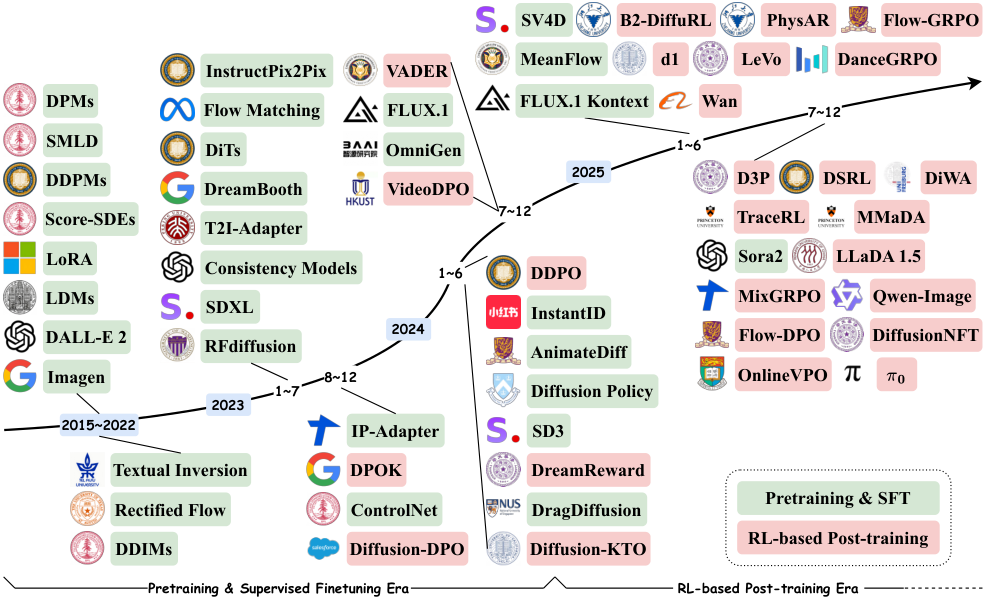
图 2 RL 驱动的扩散模型技术全景与演进时间线。
三大瓶颈
在给出方法论之前,论文先揭示了三个阻碍 RL 驱动的扩散模型落地的核心瓶颈:
- 奖励设计脆弱:扩散生成是高维、非平稳的空间,奖励信号极易失真,微调奖励往往导致模型崩溃。
- 高维空间中的探索-利用权衡:生成空间维度和组合爆炸式大,纯探索代价高,纯利用又陷入局部最优。
- 稀疏奖励下的训练不稳定:多数任务的奖励是终态才有(sparse),中间去噪步缺乏信用分配,训练方差极大。
四大领域:RL 如何改造扩散
论文把 RL 驱动的扩散模型分成四个应用领域,逐一给出方法梳理与实证。
语言:扩散 LLM
把扩散用于离散 token 语言建模(dLLM)时,每一步去噪都是「预测下一个词元」的并行决策。RL 的角色是为整条解码轨迹提供奖励,引导模型在自回归替代路径之外探索更优的 token 序列。
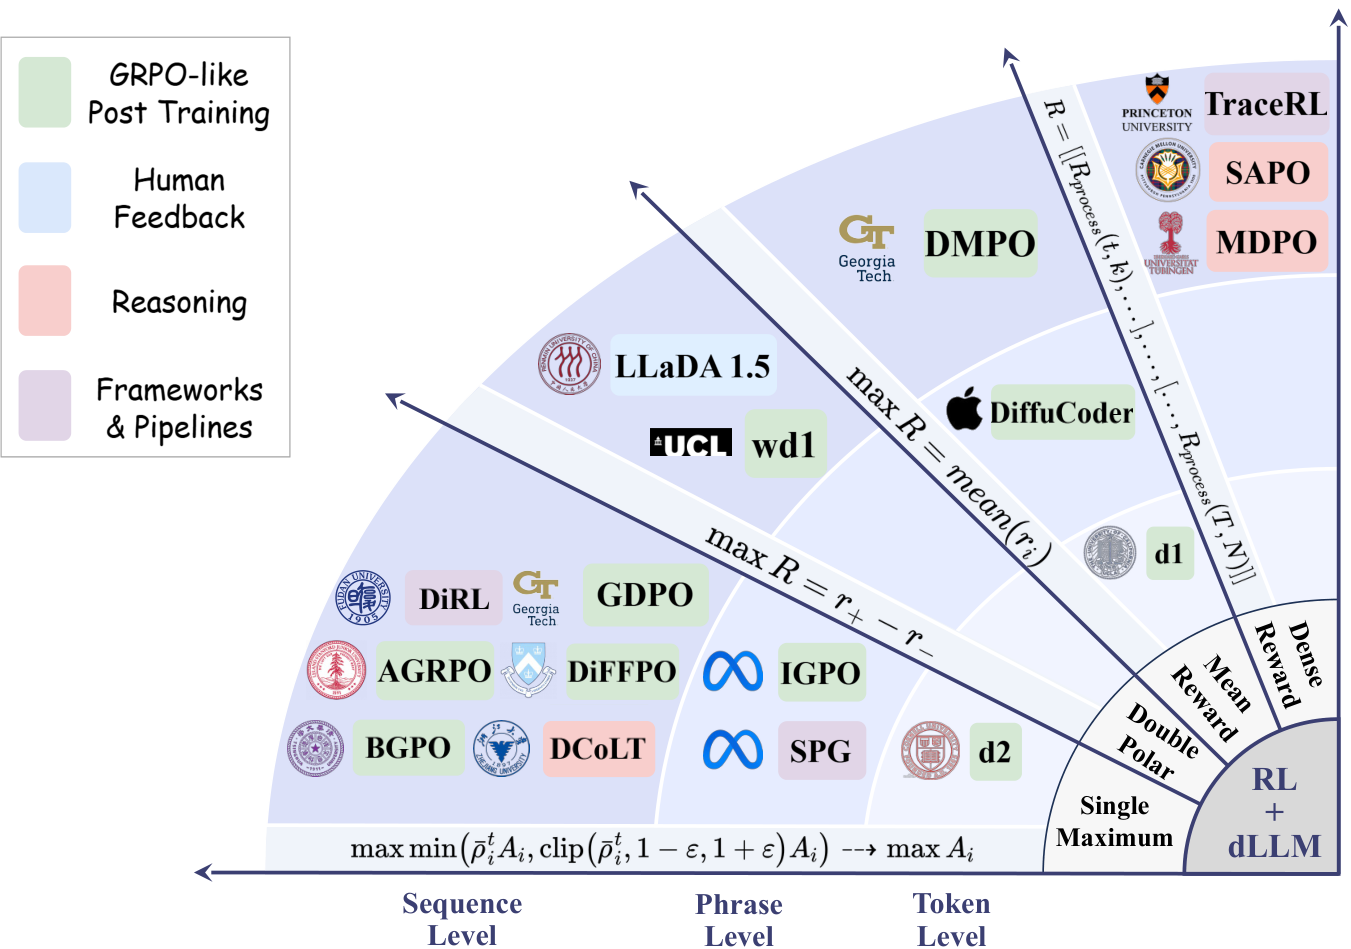
图 3 扩散语言模型(dLLM)总览:RL 介入整条解码轨迹。
多模态:从文本到图像、视频
多模态扩散(文生图、视频生成)是 RL 落地最成熟的场景。论文按「底层 RL 技术演进」和「RL 驱动的扩散多模态任务」两条线索组织。图像生成是主战场:奖励来自美学评分、CLIP 相似度、人类偏好对齐等,直接作用于最终图像。
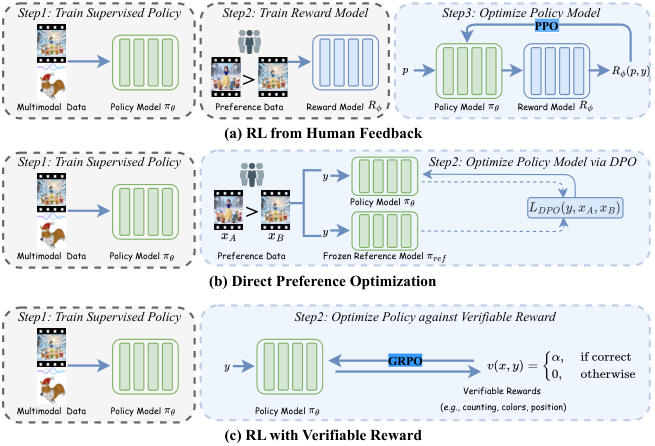
图 4 多模态扩散 RL 技术分类。
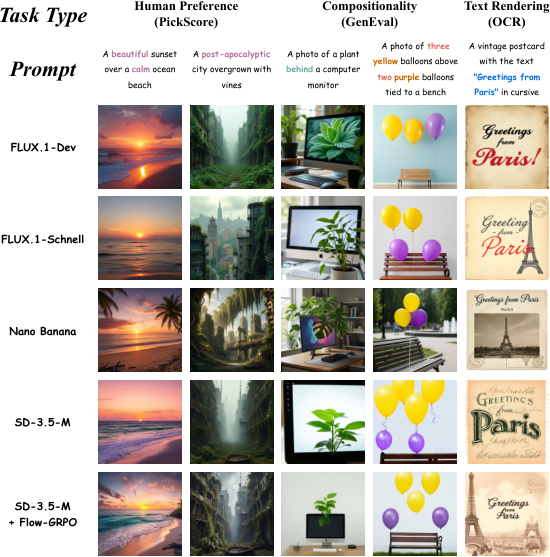
图 5 文本到图像生成中的 RL 驱动扩散。
机器人:扩散策略与 VLA
机器人领域,扩散模型用作动作策略(diffusion policy),RL 训练让策略在物理交互中优化轨迹。VLA(视觉-语言-动作)模型里,生成专家(generative expert)承担动作输出,RL 则对齐视觉语言指令。
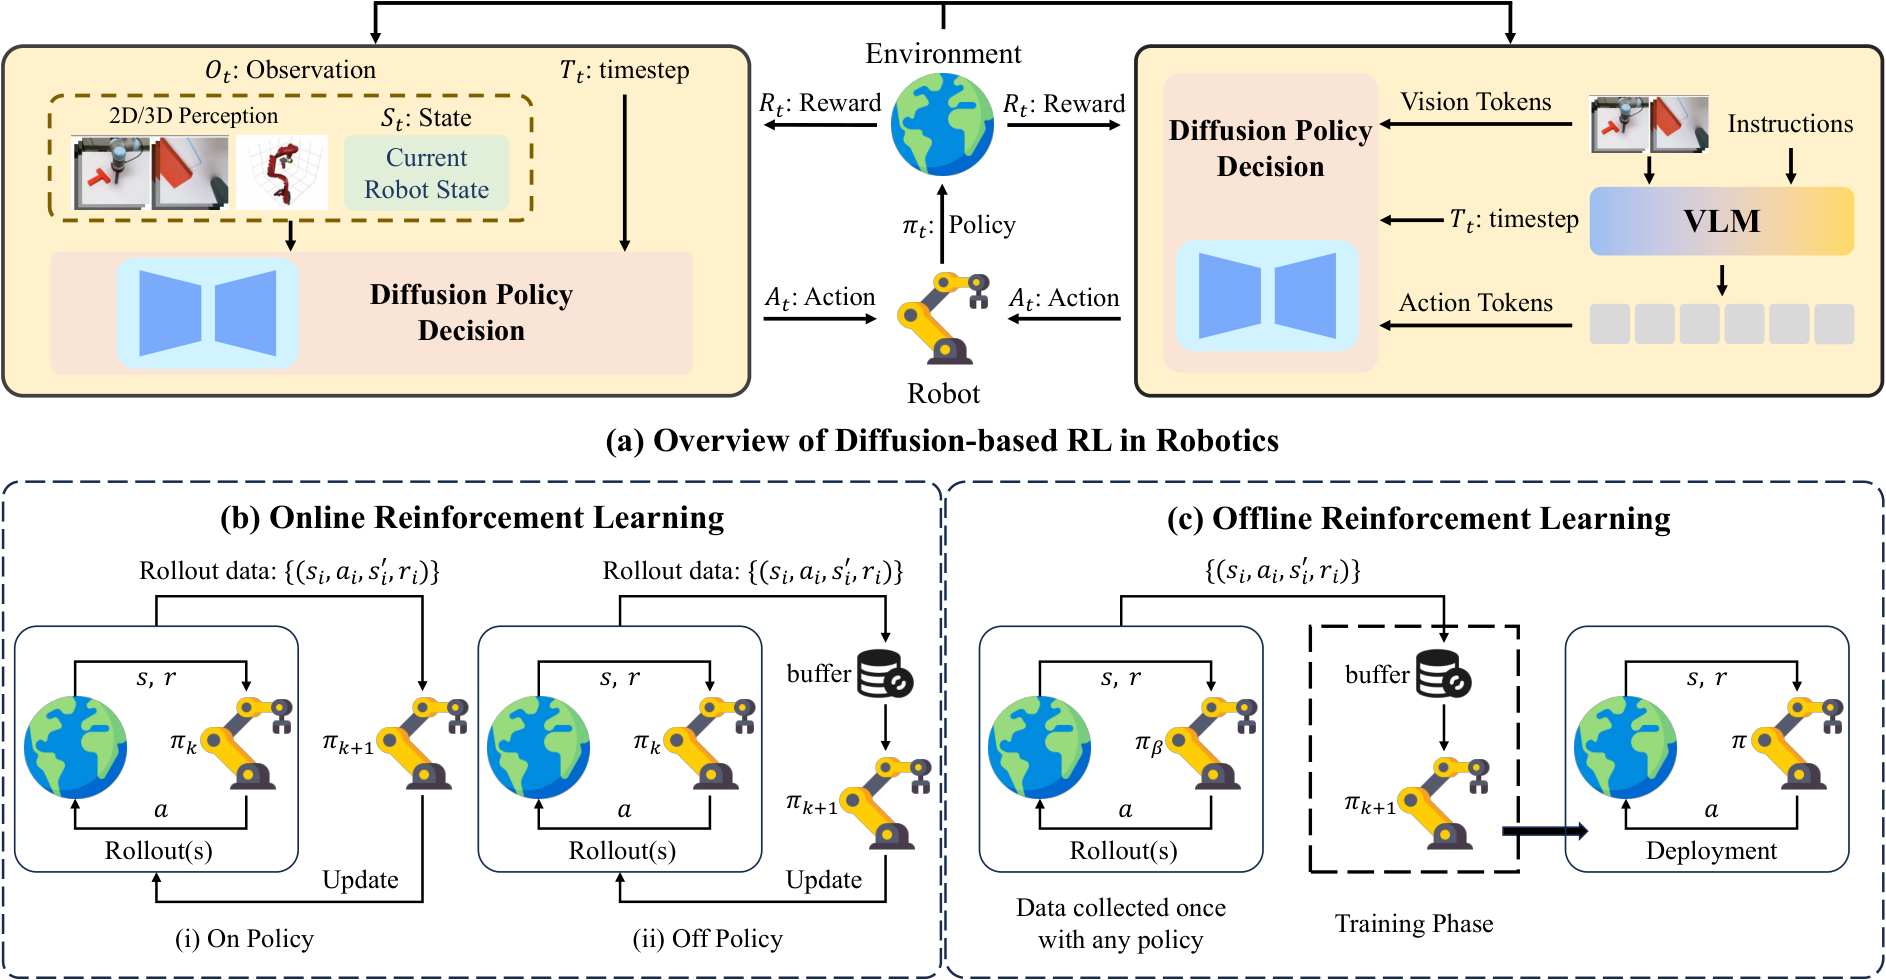
图 6 扩散策略驱动的机器人 RL 训练与 VLA 生成专家。
科学模型:从分子到物理场
科学扩散覆盖离散分子序列生成、连续 3D 结构生成、周期性晶体结构生成、连续物理约束场建模,以及科学成像与逆重构。RL 在这里的奖励来自物理一致性、能量最小化、可合成性等硬约束,比多模态更强调可验证性。
结论与路线图
论文最后给出一条原则性路线图:把 RL 集成进扩散模型时,应优先解决奖励设计、探索-利用权衡与稀疏奖励稳定性三大瓶颈,再谈泛化与可解释性。未来方向指向更鲁棒、可解释的 RL-扩散系统。
参考链接
- 论文:arXiv:2610.21539 — Reinforcement Learning-driven Diffusion Models: Language, Vision, and Beyond(TPAMI)
- 配套仓库:论文中给出的公开 GitHub 仓库,持续跟踪该领域最新工作